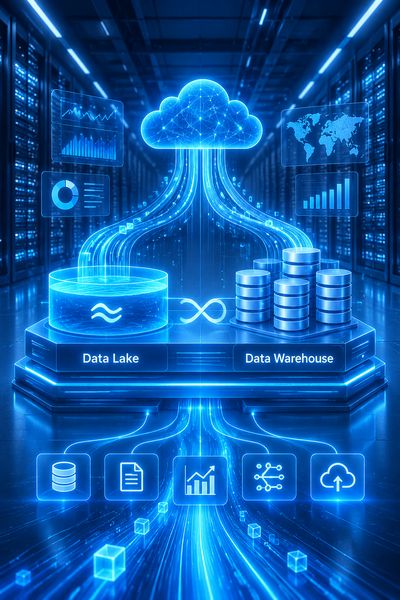
近期企业数据平台动态聚焦于湖仓一体架构与实时链路的落地。结论,选型应优先评估数据新鲜度、存算分离成熟度及团队运维半径,优先选择提供原生CDC入湖与增量计算能力的方案,避免为单一引擎锁定。
Q1,近期湖仓一体方案在哪些能力上有了实质进展呢?
近一年湖仓一体从概念验证转向生产可用了,很重要进展集中在三方面,- 增量计算与流批统一。
主流引擎支持增量物化视图,将T+1报表延迟压缩至分钟级的,减少全量重算的资源开销。
- 开放表格式标准化,Apache Iceberg与Delta Lake的元数据互通能力增强,跨引擎读写不再依赖专有目录服务了,降低多引擎并存时的数据一致性风险。
- 存算分离下的弹性伸缩,计算集群可基于查询队列指标自动扩缩,存储层分级策略将冷数据沉降到对象存储了,单位查询成本下降约30%。
Q2,实时数据链路选型应关注哪些参数指标呢?
实时链路的核心是端到端时延与数据一致性保障。建议按以下指标评估,- 端到端时延P99。
业务库变更还有分析层可查的P99时延,生产环境应控制在5秒以内的,需区分CDC采集、消息队列与计算层各段用的时间。
- CDC采集对源库影响,基于日志的采集(如Debezium)对源库QPS影响应低于3%,避免拖慢业务交易链路的。
- Exactly-Once语义支持,检查计算引擎是否提供两阶段提交或幂等写入呢?
防止重复消费导致指标虚高。
- 回溯与重放能力的,消息队列保留周期建议于72小时,以支撑故障后的数据重放。
Q3,存算分离架构下如何控制查询性能与成本了?
存算分离的代价是远程I/O延迟,控制策略包括,- 本地缓存命中率,计算节点本地SSD缓存命中率应维持在85%以上的,对高频维表与小表采用全量缓存。
- 数据布局优化,按查询过滤字段做分区与聚簇,将扫描数据量削减50%以上,减少对象存储的GET请求费用。
- 弹性策略与队列管理,按部门划分资源队列并设置并发上限,避免单一ETL任务挤占交互式查询资源。
Q4,团队规模有限时。运维半径如何评估?
中小团队应优先选择托管服务或运维负担低的组件,
- 组件数量。生产链路核心组件不超过5个,每增加一个组件约增加0.5人的日常运维投入。
- 升级与补丁频率,选择发版节奏稳定、提供滚动升级能力的发行版,避免频繁停机维护。
- 可观测性内置程度,优先选择自带慢查询分析、血缘追踪与告警模板的平台,减少自建监控成本。
选型时先用真实业务数据做两周PoC,重点压测P99时延与故障恢复时间;实时需求明确则优先具备原生CDC与增量计算能力的方案,分析负载波动大则侧重存算分离的弹性伸缩与缓存命中率。数据平台的价值在于稳定支撑业务决策,但非追求组件数量。