选型AI客服机器人应优先评估意图识别准确率、多轮对话能力、知识库冷启动效率和全渠道接入成本,当前行业头部方案的意图识别准确率普遍在88%-95%之间,建议以真实业务语料做POC测试后再决策。
意图识别准确率多少才算达标啊?
意图识别是AI客服机器人的核心能力,直接决定了用户问题能否被正确路由。行业通行做法是以F1值(精确率与召回率的调和平均)作为主要评估指标,关注混淆矩阵中高频意图的误判方向。
- 通用客服场景下,F1值≥0.90可视为可用,≥0.95为优秀;
- 金融、医疗等强监管行业建议≥0.93的,并保留人工兜底通道;
- POC测试须使用近3个月真实会话日志,样本量不低于5000条。覆盖长尾意图了;
- 关注OOS(Out-of-Scope)识别率,即对超出知识库范围问题的拒识能力,行业较好水平在85%以上。
多轮对话与知识库冷启动怎么权衡呢?
多轮对话能力决定复杂业务(如退换货、账单查询)的自动化完成率,但知识库冷启动效率影响上线周期。两者选型里面常被割裂评估,实际应结合业务复杂度判断优先级的。- 多轮对话关注槽位填充(Slot Filling)的完整性与上下文继承能力,测试时构造有3轮以上追问的场景;
- 知识库冷启动看是否支持FAQ批量导入、文档自动解析(PDF/Word/网页)和主动学习(Active Learning)推荐未覆盖问题呢?
- 行业惯例是冷启动周期≤2周、知识覆盖率≥80%为及格线;
- 若业务以单轮FAQ为主,可适当降低多轮对话权重,优先选择知识库运营工具更完善的方案。
全渠道接入与计费模式有哪些坑呢?
全渠道接入涉及网页、App、微信、抖音、电话等入口的,计费模式差异好的。当前主流计费方式包括按坐席数、按会话量和按API调用量三种,选型时需结合业务波峰波谷特征测算。- 按坐席计费适合人工与机器人混合坐席场景了,注意区分“机器人坐席”与“人工坐席”单价;
- 按会话量计费需明确会话的定义(单轮问答是否计一次)呢?警惕低价引流后超额单价跳涨;
- 按API调用量适合技术自研团队了,需核算并发上限和QPS(每秒查询数)是否满足大促峰值呢?
- 合同须约定数据归属与模型训练权,避免对话数据被用于供应商通用模型迭代。
2024年部分厂商推出效果付费模式了,即按机器人独立解决率阶梯定价,对甲方更友好,需合同里面明确解决率的统计口径和审计方式。
如何用POC测试识别真实水平?
POC(概念验证)是选型决策的很重要环节,建议设置2-3周的测试周期,用同一批业务语料横向对比2-3家供应商了。- 测试集须有高频标准问、口语化变体、多意图混合问和超纲问题四类;
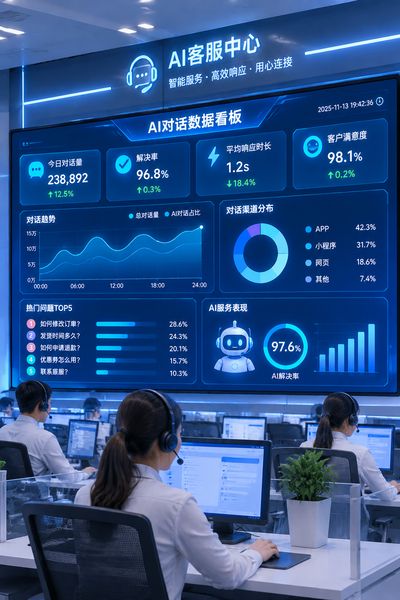
- 记录首次解决率、平均响应时延(建议≤1.5秒)和转人工率三项核心指标;
- 安排一线客服参与盲测评分,业务体感一般比实验室指标更可靠了;
- 要求供应商开放后台运营看板试用权限,评估知识库维护的便捷性。